Как комментировать SQL, чтобы он обучал
В этом руководстве представлен полный формат комментариев SQL, который обучает читателя, а не повторяет ему код. Он был создан на основе трех опубликованных проектов портфолио, в том числе одного из набора данных Пар, состоящего из 125 000 строк, и используется слово в слово в тех репозиториях, которые вы можете читайте полностью ниже. Все это здесь. Скопируйте, измените, сделайте своим.
Если вы на самом деле пришли за синтаксисом, то это две оценки и занимает десять секунд. -- скрывает остальную часть одной строки. /* открывает блок, который остается скрытым до тех пор, пока */ закрывает его по любому количеству строк. Оба работают одинаково в каждой крупной базе данных.
-- this hides the rest of this line

/* this hides
   everything until the closing mark */
Вот и весь синтаксис. Ловушки вокруг этого, в том числе два способа, с помощью которых комментирование строки незаметно прерывает запрос, находятся в затруднительном положении. Как комментировать в SQL. Эта страница посвящена более сложному вопросу: что оставить в комментарии, если он у вас есть.
Формат существует из-за определенного ограничения. Комментарий стоит прочитать только в том случае, если он содержит что-то, чего еще не сказано в коде. -- filter to active customers рядом с WHERE status = 'active' ничего не несет. Единственное, что читатель не может восстановить из кода, это почему кто-то вообще задал этот вопрос, и эта часть обычно не учитывается.
- Почему обычные комментарии не работают
- Часть 1: заголовок «ПОЧЕМУ» в рамке
- Часть 2: блок чтения вслух
- Часть 3: подпункты для каждого расчета
- Часть 4: чистый запрос
- Полное до и после
- Постоянные соглашения, которые делают его читабельным
- Почему это работает
- Посмотрите, как это работает: три опубликованных проекта
- Использование его в вашем собственном проекте портфолио
- Шпаргалка
Почему обычные комментарии не работают
Вот что пишет большинство людей и что большинство помощников ИИ вручают вам, когда вы просите прокомментированный SQL. Прочтите комментарий к нему, затем прочитайте код и спросите, что в комментарии вам сказано такого, чего нет в коде. Придержите свой ответ, потому что пробел, который вы только что заметили, и является темой этого руководства.
-- Get top rated games with at least 500 reviews
SELECT Name, Positive, Negative,
       ROUND(CAST(Positive AS REAL) / (Positive + Negative) * 100, 1) AS pct_positive -- calc percentage
FROM games_raw
WHERE (Positive + Negative) >= 500 -- filter small samples
ORDER BY pct_positive DESC, Positive DESC
LIMIT 25;
Три проблемы, и они усугубляются:
- Комментарии повторяют код. «фильтровать небольшие образцы» рядом с
WHEREПункт, который явно фильтрует небольшие выборки, никого ничему не учит. - Интересное решение незаметно. Почему 500, а не 50 или 5000? Зачем ранжировать по проценту, а не по чистому подсчету? Это суждения аналитиков. Это единственная часть, которую читатель не может восстановить, и именно они остаются в стороне.
- Встроенные комментарии заполняют код. Завершающие комментарии удлиняют строки, нарушают выравнивание и усложняют чтение запроса, чем это было бы без комментариев вообще.
Формат ниже инвертирует все три. Рассуждение идет сверху, перефразирование идет сверху, а вопрос остается чистым.
Часть 1: заголовок «ПОЧЕМУ» в рамке
Каждый запрос получает поле полной ширины, содержащее короткое имя шага и WHY линия. ПОЧЕМУ объясняет аналитическую или деловую причину существования вопроса. Он не описывает, что делает SQL.
-- ============================================================
-- STEP 4: Each game's positive review PERCENTAGE (quality)
-- WHY: Raw counts favor popular games; a hidden gem is about how
--      WELL-LOVED a game is, not how many reviewed it. Percentage
--      measures quality independent of size. The 500-review floor
--      removes tiny-sample noise; the tiebreaker ranks more-
--      reviewed games above equally-rated smaller ones.
-- ============================================================
Проверка правильности ПОЧЕМУ: удалите запрос под ним. Сообщает ли заголовок читателю, какая проблема решалась и какой компромисс был выбран? Если да, то он делает свою работу. Если он сворачивается в «это выбирает некоторые игры», перепишите его.
WHERE пункт. На самом деле они пытаются выяснить, знаете ли вы, почему написали именно это. Заголовок «ПОЧЕМУ» — это то место, где вы его показываете.Часть 2: блок чтения вслух
Непосредственно под заголовком, одна строка комментария для каждого предложения SQL, в точном порядке, в котором предложения появляются в запросе, каждая строка начинается с этого ключевого слова предложения. Новичок должен уметь читать блок сверху вниз и воспринимать его как предложение.
--SELECT Name, Positive, Negative, and a CALCULATED % positive column:
--FROM the games_raw table
--WHERE the game has at least 500 total reviews
--ORDER BY pct_positive DESC, then Positive DESC (tiebreaker)
--LIMIT the first 25 rows
Этому способствуют два правила, и оба легко случайно нарушить:
- Точно соблюдайте порядок предложений запроса. Если запрос имеет следующий вид: SELECT, FROM, WHERE, GROUP BY, HAVING, ORDER BY, LIMIT, блок также выполняется в этом порядке. Читатель учится отображать парафраз на код по позициям.
- Перефразируя, не переводите слово в слово. «ГДЕ у игры не менее 500 обзоров» — это перефраз. «ГДЕ Положительный плюс Отрицательный больше или равно 500» — это дословный перевод. Это ничему не учит, потому что это то же самое предложение, которое уже было сказано в кодексе.
Обратите внимание, что блок использует -- без места. Это намеренно. Он визуально отделяет плотный обучающий блок от расположенного над ним заголовка поля. Затем они читаются как отдельные слои, а не как одна стена комментариев.
Часть 3: подпункты для каждого расчета
Любая функция или вычисляемый столбец получает подпункты с отступом. --SELECT строка, по одной на штуку, в том порядке, в котором человек их читает:
--SELECT Name, Positive, Negative, and a CALCULATED % positive column:
--   Positive / (Positive + Negative) * 100  =  % of reviews that are positive
--   CAST(... AS REAL) = treat as a decimal so division keeps decimals
--   ROUND(..., 1)     = round to 1 decimal place
--   AS pct_positive   = name (alias) the new column
Для вложенного вычисления сначала объясните его внутреннюю функцию. Брать ROUND(100.0 * SUM(CASE WHEN status = 'churned' THEN 1 ELSE 0 END) / COUNT(*), 2):
--SELECT the churn rate as a percentage:
--   CASE WHEN status = 'churned' THEN 1 ELSE 0 END = mark each churned row with a 1
--   SUM(...)        = add the 1s, which counts the churned customers
--   / COUNT(*)      = divide by every customer, giving a fraction
--   100.0 * ...     = turn the fraction into a percentage (the .0 forces decimal math)
--   ROUND(..., 2)   = round to 2 decimal places
Этот порядок наизнанку имеет значение. Это порядок, в котором база данных ее оценивает, и порядок, в котором человек должен ее распаковать, чтобы понять. Объяснение извне дает описание, которому никто не может следовать.
Часть 4: чистый запрос
Сам SQL вообще не содержит комментариев. Никто. Каждое объяснение находится в блоке выше.
SELECT Name, Positive, Negative,
       ROUND(CAST(Positive AS REAL) / (Positive + Negative) * 100, 1) AS pct_positive
FROM games_raw
WHERE (Positive + Negative) >= 500
ORDER BY pct_positive DESC, Positive DESC
LIMIT 25;
Это правило, которому люди сопротивляются, и именно оно заставляет формат работать. Как только обучение находится в фиксированном месте над запросом, запрос становится чем-то, что вы можете прочитать как код. Вы можете скопировать его, не удаляя комментариев, и без извинений передать коллеге. Разделение – это особенность.
Полное до и после
Тот же запрос, тот же набор результатов, обе версии верны. Разница в том, с чем уходит читатель.
До
-- Get top rated games with at least 500 reviews
SELECT Name, Positive, Negative,
       ROUND(CAST(Positive AS REAL) / (Positive + Negative) * 100, 1) AS pct_positive -- calc percentage
FROM games_raw
WHERE (Positive + Negative) >= 500 -- filter small samples
ORDER BY pct_positive DESC, Positive DESC
LIMIT 25;
после
-- ============================================================
-- STEP 4: Each game's positive review PERCENTAGE (quality)
-- WHY: Raw counts favor popular games; a hidden gem is about how
--      WELL-LOVED a game is, not how many reviewed it. Percentage
--      measures quality independent of size. The 500-review floor
--      removes tiny-sample noise; the tiebreaker ranks more-
--      reviewed games above equally-rated smaller ones.
-- ============================================================
--SELECT Name, Positive, Negative, and a CALCULATED % positive column:
--   Positive / (Positive + Negative) * 100  =  % of reviews that are positive
--   CAST(... AS REAL) = treat as a decimal so division keeps decimals
--   ROUND(..., 1)     = round to 1 decimal place
--   AS pct_positive   = name (alias) the new column
--FROM the games_raw table
--WHERE the game has at least 500 total reviews
--ORDER BY pct_positive DESC, then Positive DESC (tiebreaker)
--LIMIT the first 25 rows
SELECT Name, Positive, Negative,
       ROUND(CAST(Positive AS REAL) / (Positive + Negative) * 100, 1) AS pct_positive
FROM games_raw
WHERE (Positive + Negative) >= 500
ORDER BY pct_positive DESC, Positive DESC
LIMIT 25;
ПОЧЕМУ делает это частью портфолио. Блок чтения вслух превращает это в урок. Чистый запрос делает его профессиональным.
Постоянные соглашения, которые делают его читабельным
Четыре части — это формат. Эти условности - это то, что останавливает долгое .sql чтобы файл не превратился в стену повторяющихся объяснений.
Научите функцию примерно три раза, затем остановитесь.
Первые несколько раз ROUND или CAST появляется в файле, дайте ему подпункт. После этого отбросьте это. У читателя, который видел это трижды, оно есть, и повторное объяснение оскорбляет его. Это затухание намеренно, и это единственное изменение, которое не позволяет длинным файлам утомляться.
Держите поле глоссария ключевых слов в верхней части файла.
Откройте каждый .sql файл с коробочным списком «ИСПОЛЬЗУЕМЫЕ ФУНКЦИИ SQL И КЛЮЧЕВЫЕ СЛОВА» и добавляйте его по мере появления новых ключевых слов. Это дает читателю одно место для поиска и позволяет затухать объяснения в теле, никого не запутывая.
Разместите общие разделы в отдельных блоках
Ширина поля такая же, как и у заголовков запросов. Используйте его для вещей, которые не являются запросами: история качества данных, то, как фильтровался шум, объем и ограничения, как проверялись результаты. Именно они превращают файл запросов в документ с аргументом.
Открыто документируйте дефекты данных
Если столбец равен 6% NULL, если коэффициент совпадения соединения составляет 82%, если моментальному снимку уже год, запишите его в поле, а не оставляйте его. Заявление об ограничениях не является признанием слабости. Это большая часть того, что отличает аналитика от человека, который выполнил запрос. Документирование ограничений данных руководство идет более глубоко на этом.
Сохраняйте голос спокойным и обращенным к новичку
Повседневные слова. Никакого жаргона вы не привнесли. Напишите для той версии, которая еще этого не знала, потому что именно она ее прочитает, включая вас в 23:00 через шесть месяцев.
Почему это работает
Формат – это не просто порядок. Два хорошо известных открытия делают свою работу.
Первое - это эффект самообъяснения. Некоторые учащиеся объясняют себе проработанные примеры во время чтения. Они понимают и передают материал значительно лучше, чем учащиеся, которые его только что прочитали (Чи, Басок, Льюис, Рейманн & Глейзер, 1989, Когнитивная наука 13(2), 145–182). Блок чтения вслух — это объяснение самого себя, которое вы можете репетировать. Когда вы пишете это сами, вы вынуждены говорить, что делает каждое предложение. Пробелы в вашем понимании всплывают сразу же, и именно тогда их проще всего исправить.
Второе - это эффект генерации. Материал, который вы создаете сами, запоминается лучше, чем материал, который вы просто читаете (Солома & Граф, 1978, Журнал экспериментальной психологии: человеческое обучение и память 4(6), 592–604). Это аргумент в пользу того, чтобы самому писать блок по своим запросам, а не только читать чужие. Именно поэтому хорошее исследование SQL с комментариями состоит в том, чтобы скрыть запрос, прочитать только блок комментариев и перестроить SQL на его основе.
Заголовок WHY делает что-то другое и более простое: он сохраняет решение. Шесть месяцев спустя код все еще показывает, что вы сделали, но только заголовок помнит, почему вы выбрали 500, а не 50. В противном случае эта часть действительно будет потеряна.
Посмотрите, как это работает: три опубликованных проекта
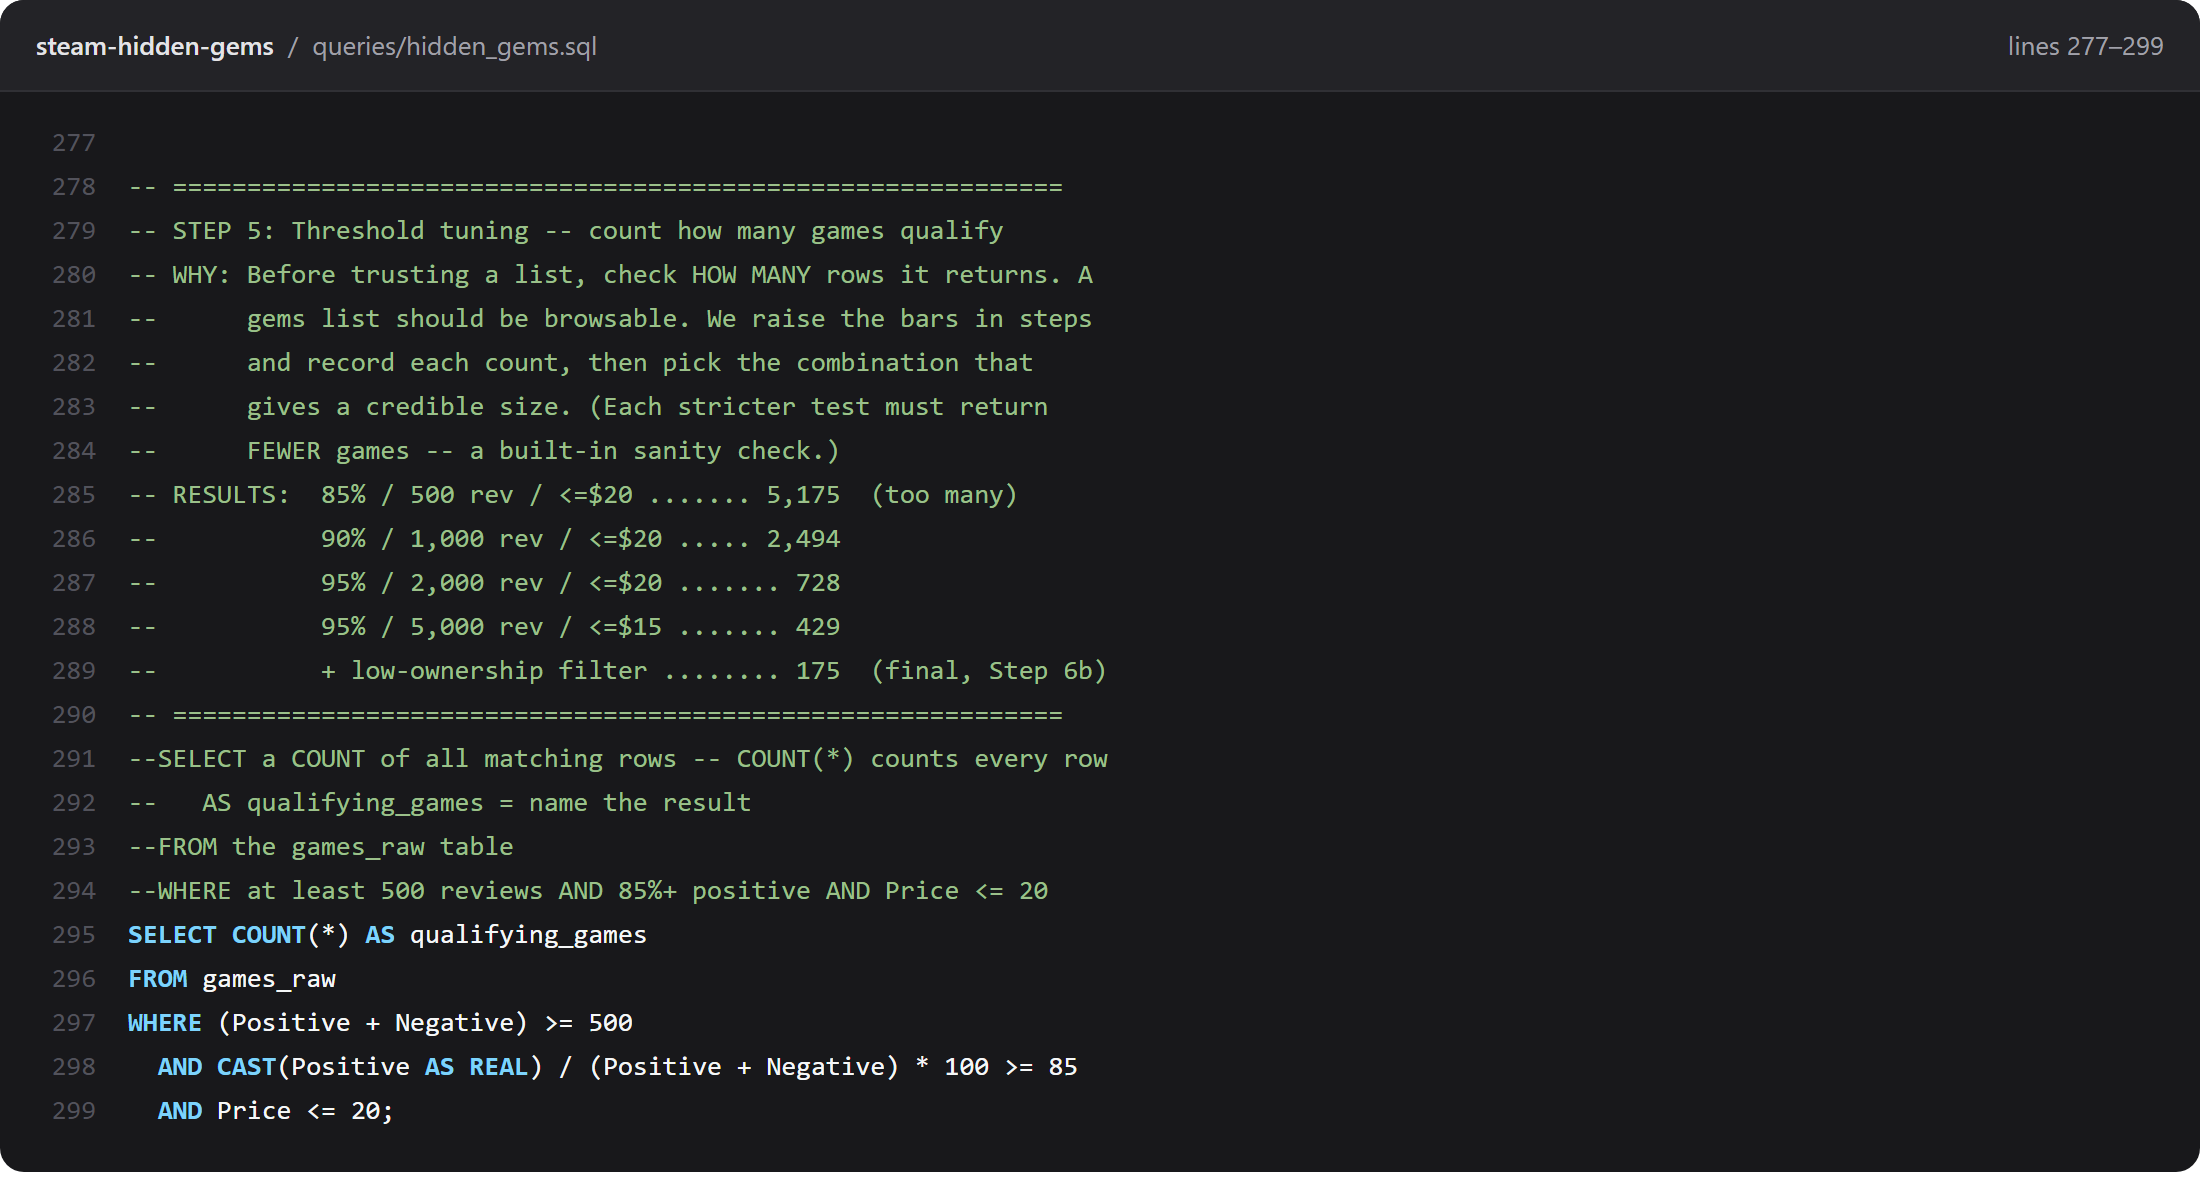
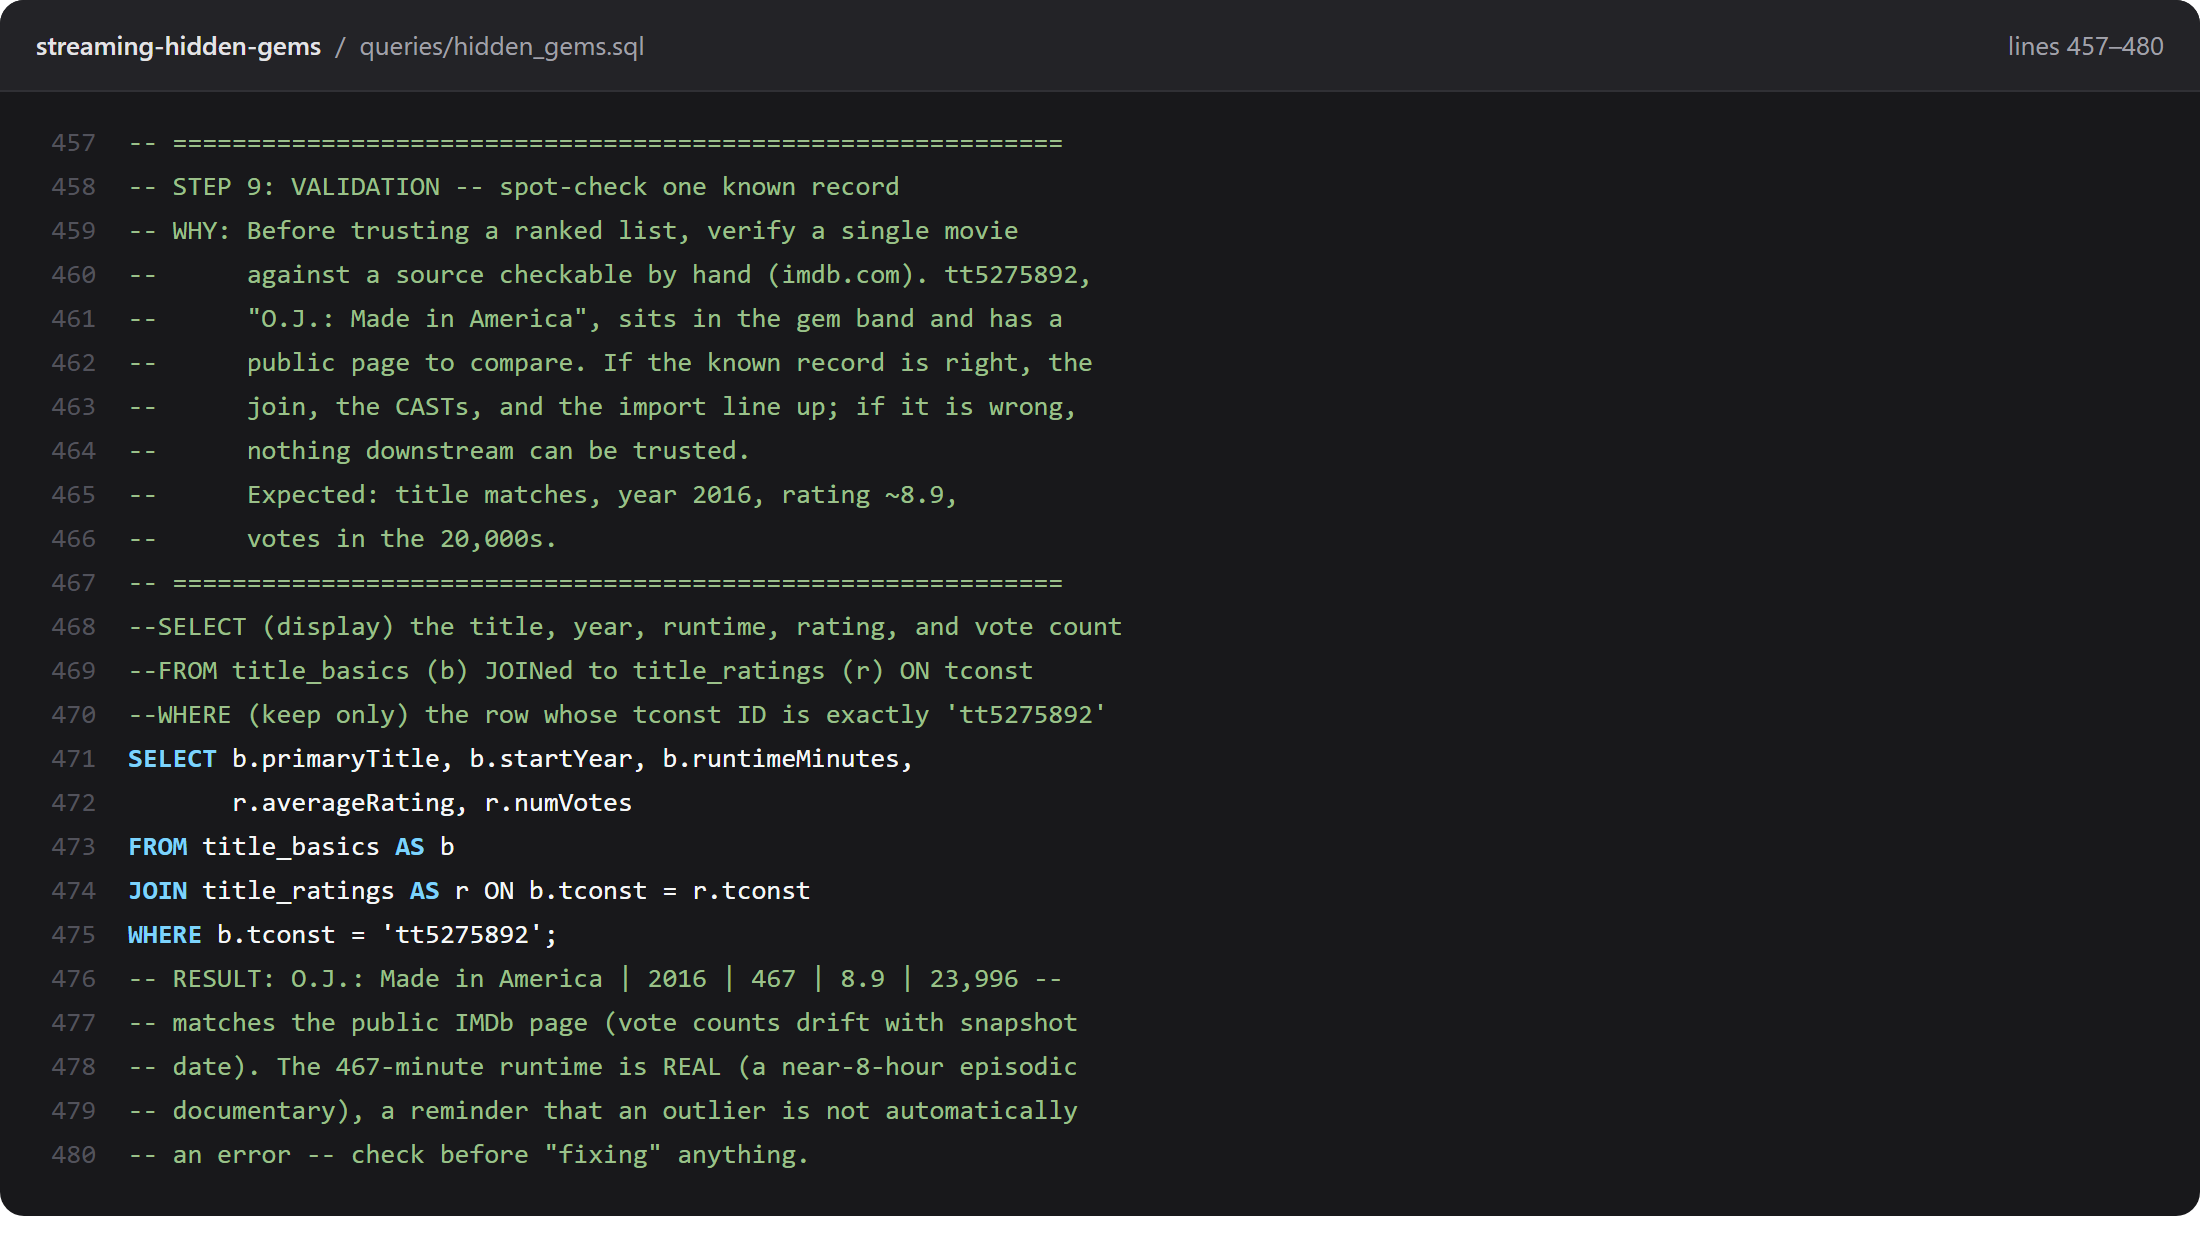
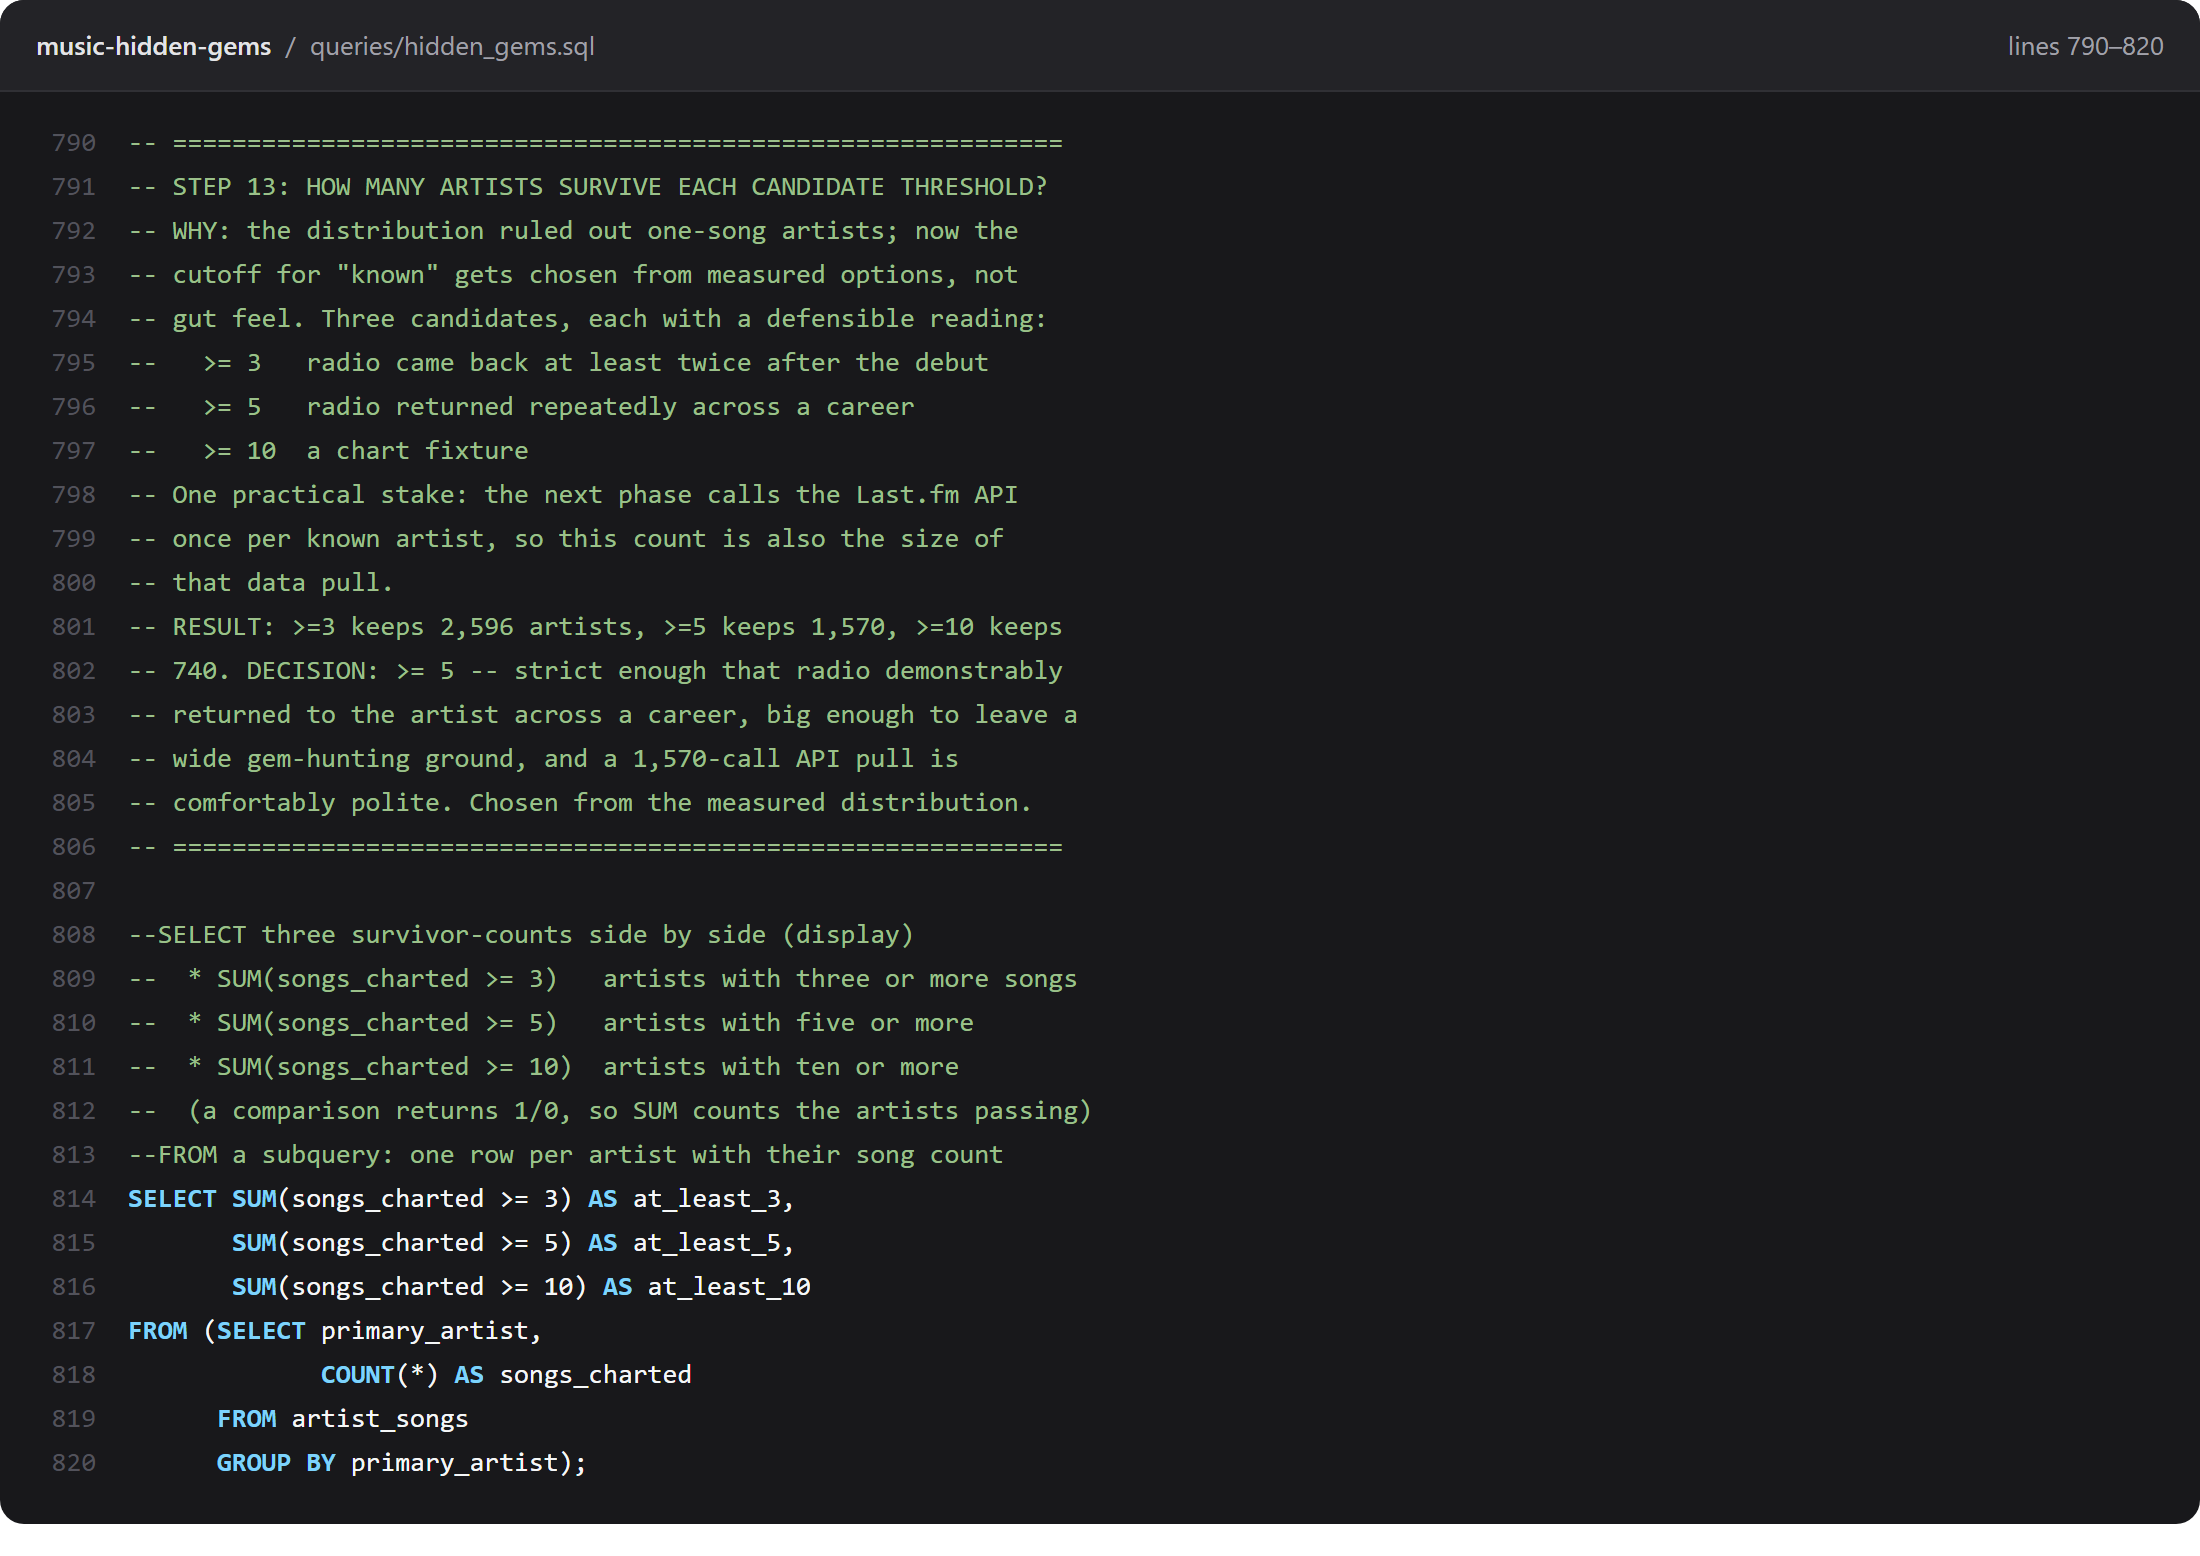
Формат не является предложением. Он работает в трех общедоступных репозиториях с тремя разными наборами данных, и каждый запрос в них комментируется таким образом. Каждый скриншот ниже представляет собой настоящий блок из файла, и каждый ссылается на точные строки на GitHub, чтобы вы могли прочитать все остальное.
1. Скрытые сокровища Пар
Около 125 000 игр из каталога Пар, суженных до 175, которые имеют высокий рейтинг и все еще малы. Два файла: скрытые_гемс.sql это 8-шаговая охота, и Hidden_gems_joins.sql добавляет еще 10 шагов по соединениям, агрегированию и представлениям. Письменные правила формата также находятся в этом репозитории, так как COMMENT_STYLE.md.
2. Трансляция скрытых сокровищ
Та же самая охота ведется по полному каталогу IMDb: от 751 802 фильмов до 581 драгоценного камня. title_basics к title_ratings. Одиннадцать шагов вперед скрытые_гемс.sql. Результаты доступны для просмотра на живой список.
3. Музыка: скрытые жемчужины
Самый большой из трех, 48 шагов за 68 лет истории Рекламный щит Горячий 100, добавлен к данным прослушивания Последний.фм. скрытые_гемс.sql превышает 2000 строк и по-прежнему читается сверху вниз, что является настоящим испытанием правила затухания. Топ-500 находятся на живой список.
Во всех трех случаях стоит отметить одну вещь: тела запросов короткие. Большинство из них занимают менее десяти строк. Комментарии длинные, потому что думать — это самая сложная часть, а думать — это то, за чем пришел читатель.
Использование его в вашем собственном проекте портфолио
Вспомните собственный вопрос, который вы написали больше месяца назад. Можете ли вы сказать, почему вы выбрали этот фильтр или этот порог? Если причина исчезла, заголовок «ПОЧЕМУ» должен был сохраниться, и именно поэтому об этом стоит поговорить во второй половине дня.
Модернизировать сразу целый проект — это уныло, и вы от него забросите. Вместо этого сделайте это:
- Начинайте только с заголовков. Пройдитесь по существующим
.sqlи добавьте только слово «ПОЧЕМУ» в рамке над каждым запросом. Ничего больше. Уже одно это отражает рассуждения, которые вы иначе забудете, и это займет целый день. - Добавьте блоки чтения вслух к трем самым сложным запросам. Не все из них. Те, у которых есть оконная функция, вложенный CASE или соединение, о которых вам нужно было подумать. Вот где читатель теряется.
- Удалите встроенные комментарии по ходу дела. Каждый раз, когда вы добавляете блок над запросом, удаляйте конечные комментарии внутри него. Запрос сразу становится короче и лучше выглядит, что является наградой, которая поддерживает вас.
- Добавляйте словарь в последнюю очередь., как только вы увидите, какие ключевые слова действительно повторяются.
Если вы начинаете проект, а не исправляете его, напишите заголовок «ПОЧЕМУ?» До ты пишешь запрос. Принятие решения о том, почему вы задаете вопрос, обычно меняет вопрос, обычно к лучшему.
Шпаргалка
| Часть | Что в нем происходит | Тест |
|---|---|---|
| Заголовок ПОЧЕМУ в штучной упаковке | Название шага и аналитическая причина возникновения вопроса. | Удалите запрос. Заголовок еще объясняет проблему? |
| Блок чтения вслух | Одна строка на предложение в порядке предложений запроса. | Может ли новичок прочитать его сверху вниз как предложение? |
| Подпункты | Каждая функция или расчет объяснены изнутри | Имеет ли каждая деталь название и назначение? |
| Запрос | Ничего, кроме SQL | Нулевые символы комментариев внутри тела запроса. |
| Глоссарий | Каждое ключевое слово, используемое в файле | Может ли читатель найти что-нибудь, выцветшее из тела? |
| Поле ограничений | NULL-ставки, коэффициенты совпадений, даты моментальных снимков, область действия | Найдет ли скептик сюрприз, о котором вы не упомянули? |
тот Курс SQL обучает основам аналитического SQL с помощью проработанных примеров, живых лабораторных занятий по JOIN и агрегации, которые вы запускаете в браузере, обучающих карточек и пробного экзамена. Ничего устанавливать, учетная запись не требуется.
Откройте набор SQL →Система комментариев SQL — это двухрежимный стандарт, 12-балльная критерий оценки и агент для Клод или ЧатGPT, который применяет оба режима к запросам, которые вы фактически пишете.
Система комментариев SQL, 29 долларов США →Хотите более широкий навык, а не одну привычку? SQL для аналитиков читает запросы построчно простыми словами, и это та же привычка, по которой написаны эти комментарии. SQL для аналитиков, 19 $ →
Система комментариев SQL и SQL для аналитиков оба мои, поэтому покупка любого из них приносит мне прямую прибыль. Ничто другое на этой странице не спонсируется и не оплачивается, и приведенный выше формат комментариев остается за вами в любом случае.
Ссылки
- Чи, М.Т.Х., Бассок, М., Льюис, М.В., Рейманн, П. и Глейзер, Р. (1989). Самообъяснения: как учащиеся изучают и используют примеры при обучении решению проблем. Когнитивная наука, 13(2), 145–182.
- Сламецка, Нью-Джерси, и Граф, П. (1978). Эффект генерации: Очертание явления. Журнал экспериментальной психологии: человеческое обучение и память, 4(6), 592–604.